Snake zonder gamecode: een neuraal netwerk is het spel
Ik trainde een neuraal netwerk om Snake te zijn: het tekent elke pixel en draait het spel in je browser. Hoe ik het bouwde, en waar wereldmodellen heen kunnen.
Deze Snake heeft geen gamecode. Een neuraal netwerk tekent elke pixel die je ziet: de slang, het eten, de scorebalk, de crash en de regenboog die het scherm vult als je wint. Het houdt ook zelf het spel bij, van het ene beeld naar het volgende. De pagina eromheen weet niets van Snake. Die stuurt je toetsaanslagen naar het netwerk en laat het beeld zien dat terugkomt.
Het netwerk heeft ongeveer 620.000 parameters en past in een bestand van 2,4 MB. Het draait op je eigen apparaat, op de grafische chip als je browser dat ondersteunt en anders op de processor.
Hoe het werkt
Acht keer per seconde krijgt het netwerk drie dingen: het geheugen dat het de stap ervoor schreef, de toetsen die je ingedrukt houdt en een beetje willekeurige ruis. Het geeft het volgende beeld terug en nieuw geheugen voor de stap daarna.
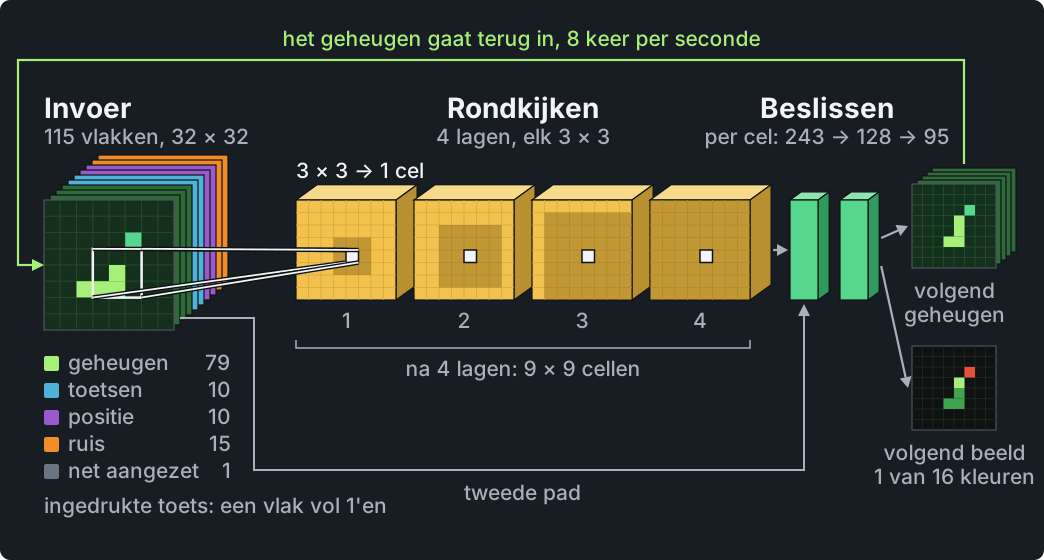
Alles van het spel zit in dat geheugen: waar de slang is, welke kant hij op gaat, de score. De pagina geeft het terug zonder het te lezen, dus het netwerk draagt het hele spel in zijn eentje. Door de ruis verschijnt eten op willekeurige plekken, ongeveer zo vaak als in het echte spel.
Hoe ik het leerde
Eerst schreef ik Snake op de gewone manier, als een klein programma. Ik noem het de leraar. Het doet maar één ding: het neemt een bord en de ingedrukte toetsen, en rekent het volgende bord uit.
Daarna liet ik een simpele bot heel veel potjes spelen tegen de leraar: sturen, eten, crashen, opnieuw beginnen. Elke stap van elk potje werd één trainingsvoorbeeld. Dit beeld en deze toetsen gaan erin, het volgende beeld komt eruit. Ik maakte ook borden die de bot zelden haalt, zoals lange slangen die in rare vormen gekruld liggen.
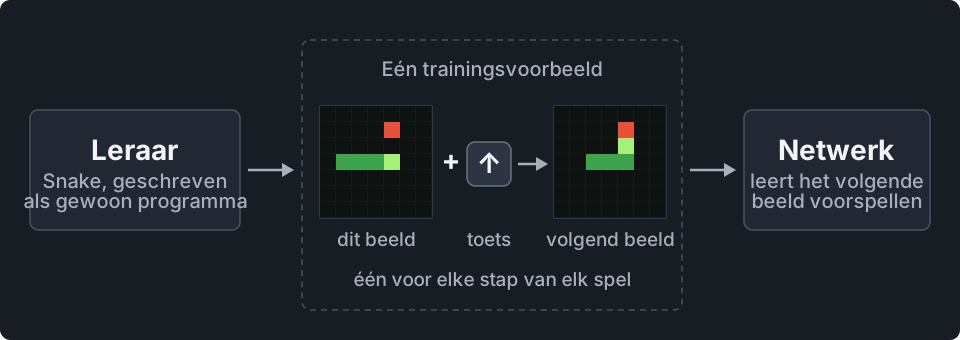
Het netwerk trainde op die paren tot het zelf het volgende beeld kon voorspellen. In de laatste rondes speelde het ook eigen potjes, en de leraar verbeterde elke stap die fout ging. Zo leerde het zich te herstellen van zijn eigen kleine fouten.
Als je speelt, krijgt je browser alleen het netwerk. De leraar blijft op mijn laptop.
Wat het moeilijk maakte
Het netwerk kijkt alleen naar een klein stukje rond elke cel, ongeveer vier cellen in elke richting. Dus elke regel in de leraar moest werken met alleen dat zicht. Daarmee valt de gewone manier om Snake te schrijven af, met een lijst van waar elk stukje van de slang zit. Om de staart weg te halen moet je dan weten waar de kop is, en die kan ver weg zijn.
Daarom heeft in de leraar elke slangcel een getal. De kop heeft het hoogste, de staart heeft 1, en een slang van 7 lang telt af van 7 naar 1. Elke stap gaat elk getal één omlaag, de 1 wordt leeg en de cel voor de kop krijgt het hoogste getal. De staart verdwijnt zonder dat iets hem hoeft te verplaatsen, en geen cel hoeft verder te kijken dan zijn buren. Eten werkt op dezelfde manier: ligt er eten in de cel voor de kop, dan krijgt die er één bij, en wordt de slang een cel langer.
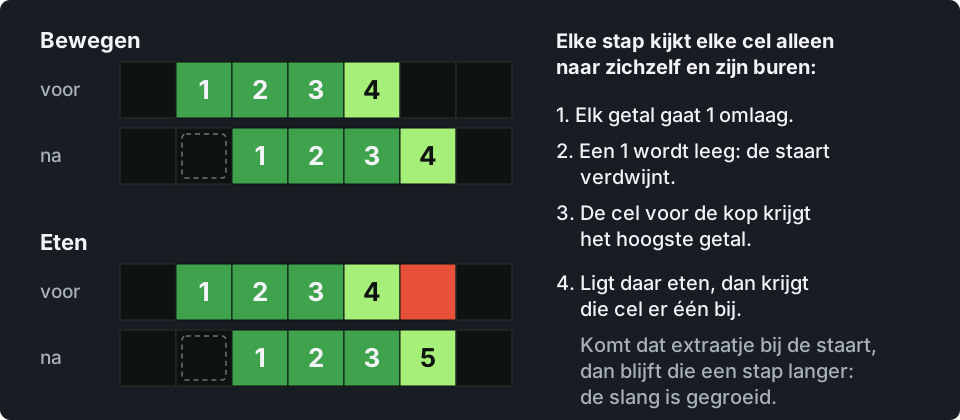
Die getallen zaten in elk trainingsvoorbeeld. Zo leerde het netwerk ze in zijn eigen geheugen te bewaren en zelf af te tellen.
De score bijhouden was verreweg het moeilijkste. Mijn eerste versies speelden goed tot de eerste hap. Daarna groeide de slang zonder te eten, raakte hij zijn kop kwijt, of bleef de scorebalk tellen na een crash. Toen ik mat waar het misging, brak in meer dan negen van de tien potjes eerst de score.
Het geheugen van het netwerk bevat meer dan je op het scherm ziet. In het eerste ontwerp was de score een getal in elke cel rond de kop van de slang. Elke stap nam een cel de hoogste score van zijn buren over. Voor het netwerk zijn een 2 overnemen en een 7 overnemen verschillende patronen, en het moet ze elk apart leren. Lage scores zaten in heel veel trainingsvoorbeelden, dus die leerde het. Hogere scores waren zeldzaam, dus die leerde het nooit. Vanaf de vierde hap hield het de oude score vast, en viel de rest van het spel eromheen uit elkaar.
Ik probeerde eerst langer te trainen, maar dat loste het niet op, dus ik veranderde hoe de score werkt. In het nieuwe ontwerp staat de score nergens meer als getal in het geheugen. Een hap laat één onzichtbaar stipje achter in het geheugen. Elke stap zakt dat stipje twee rijen, en als het bij de scorebalk komt, schuift het door tot het het volgende lege vakje oplicht. De opgelichte vakjes zijn de score. Een stipje beweegt hetzelfde bij een score van 2 of 20, dus het netwerk hoeft het maar één keer te leren. Wel loopt de balk iets achter: die laat een hap tot ongeveer twee seconden na het eten zien.
Elk trainingsvoorbeeld is nog steeds maar één stap. Het netwerk leert nooit de hele val, alleen “als er twee rijen boven mij een stipje zit, heb ik het nu”. Het krijgt elke stap zijn geheugen terug, dus door die ene regel te herhalen zakt het stipje helemaal naar beneden.
Waar dit heen kan
Minder programmeren, meer laten zien. Voor Snake schreef ik het hele spel als leraar. Ik denk niet dat dat altijd nodig blijft. Je zou de kernregels één keer kunnen programmeren, er een netwerk op trainen, en het spel daarna aanpassen met voorbeelden. Een nieuw level, een snellere slang, een tweede soort eten? Laat het netwerk wat beelden zien, de ingedrukte toetsen en het beeld dat daarna hoort te komen, en train het een beetje bij. Ik werk al een beetje zo: als ik het spel aanpas, begint het netwerk niet bij nul. Het houdt wat het weet en leert alleen het verschil.
Het is een wereldmodel. Wat dit netwerk doet, heeft in AI-onderzoek een naam: een wereldmodel. Gegeven de toestand van de wereld en een actie voorspelt het wat er daarna gebeurt. Google’s GameNGen simuleert DOOM op deze manier, en DeepMind’s Genie 3 maakt hele werelden waar je doorheen kunt bewegen. Die leren van enorme hoeveelheden beeldmateriaal en hebben zware hardware nodig, terwijl deze leerde van een klein programma en op een telefoon draait. Daardoor is het een goedkope plek om ideeën uit te proberen die op die schaal een fortuin kosten.
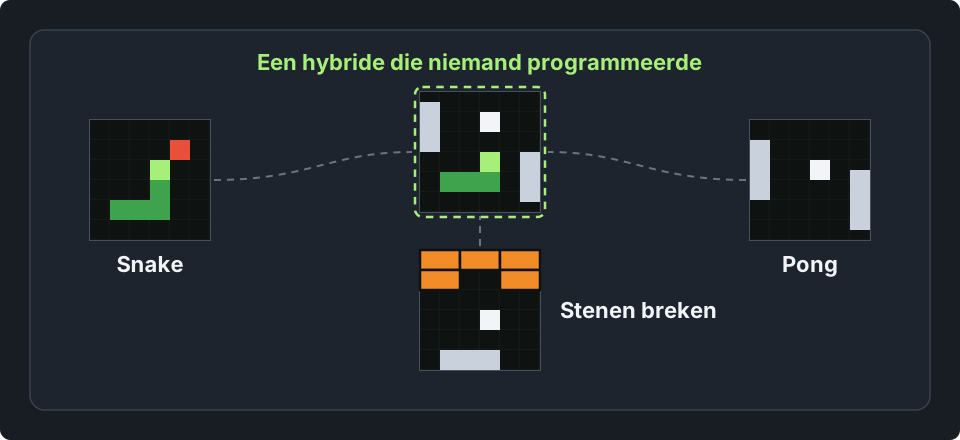
Veel spellen, één netwerk. Dit idee vind ik het spannendst. Train één netwerk op heel veel kleine spellen zoals deze, allemaal met dezelfde invoer en dezelfde kleuren. Elk spel wordt dan een plek in wat het netwerk heeft geleerd. Draai aan de knoppen tussen die plekken en je zou kunnen spelen wat ertussen ligt: iets met de beweging van het ene spel en de regels van het andere, of een neurale hybride die geen van de trainingsspellen is en die niemand ooit heeft geprogrammeerd.
Speel Snake en kijk hoe ver je komt.